AIエージェントに業務システムを操作させるなら、「事故は起きるもの」という前提に立つ必要があります。 権限をどれだけ絞っても、リスクはゼロになりません。 本番稼働の前に決めておくべき監視の仕組みと、インシデント対応の5つのフェーズを整理します。
権限を絞っても、事故はゼロにならない
以前の記事「AIエージェントに顧客データを渡す前に」では、エージェントの権限を最小限から始め、影響の大きい操作には人の承認を挟む設計を紹介しました。 ただし、どれだけ丁寧に権限を設計しても、想定外の動きやハルシネーション(もっともらしい誤り)を完全になくすことはできません。
そこで必要になるのが、「監視」と「インシデント対応」の2つです。 木にたとえると、監視は木の状態を日ごろからチェックして、腐食や折れた枝を早めに見つけること。 インシデント対応は、嵐で木が倒れたときのために、保険の内容や専門業者の連絡先を把握しておくことです。
どちらも、事故が起きてからでは間に合いません。本番に移行する「前」に整えておくものです。
AIエージェントの事故が人の操作ミスと違うのは、速さと量です。 人なら1件ずつ手で直していく作業を、エージェントは短時間に大量に実行できます。 便利さの裏返しとして、間違えたときの影響も一気に広がります。 気づくのが遅れるほど、戻す作業は大きくなります。
業務システムの記録だけでは、やり取りの全体は追えない
多くの業務システムには、もともと監視のための機能があります。 ログインやAPI呼び出しなどの操作ログ、設定変更の履歴、項目ごとの変更履歴などです。 まずはこれらを有効にし、誰が見られるかを確認しておくことが基本になります。
ただし、それぞれに限界があります。 設定変更の履歴には、エージェントによる個々のデータ操作が記録されないことがあります。 項目の変更履歴は保存期間が限られ、AIへのプロンプトや、やり取りの全体は記録されません。
もう1つの理由は、AIのやり取りが複数のシステムをまたぐことです。 たとえば「担当者がチャットツールで依頼する → 自社アプリが認証つきでリクエストを送る → エージェントが使うツールを選ぶ → ツールが業務システムを操作する」という流れです。 業務システム側の監視が見えるのは、最後の境界までです。 「誰の、どんな依頼が、この更新につながったのか」を追うには、各システムのログを関連付けておく必要があります。
本番前に文書化しておくこと
ログは「どこかにあるはず」では役に立ちません。 事故が起きてから、どのシステムの誰に頼めばログを出してもらえるのかを調べ始めると、その間に記録が消えてしまうこともあります。 本番稼働の前に、次の点を文書にしておきます。
- 所在:それぞれのログを、どのシステムが持っているか
- アクセス:誰がそのログを見られるか、どう依頼すれば取り出せるか
- 関連付け:記録同士を、どのIDや時刻で結びつけるか
- 保存期間:調査に必要な期間、ログが残る設定になっているか
- 中身:プロンプトや結果に、規制対象のデータが含まれていないか
監視の対象は、業務システムだけではありません。 外部のアプリや画面、自社で管理する中継やAPIの基盤、エージェントの実行環境とツールの振り分け、外部のAIモデル提供者、そして自社のアプリのログまでを含めて考えます。
もう1つ大切なのが、通常の活動のベースラインです。 ふだん1日に何件の操作があり、どの時間帯に、どんなツールが呼ばれているのか。 平常時の姿を知らなければ、異常に気づくこともできません。
ベースラインは、本番前の試験運用の期間に作っておくのが現実的です。 操作の件数、呼び出されるツールの種類、更新されるレコードの数を記録しておけば、 「深夜に、ふだんの何倍もの更新が走っている」といった異常を、数字で見分けられるようになります。
インシデント対応の5つのフェーズ
事故が起きたときの流れも、事前に決めておきます。 AIエージェントの事故でも、基本は一般的なセキュリティのインシデント対応と同じ5つのフェーズで考えられます。
大切なのは、各フェーズで「誰が」「何を判断し」「何を記録するか」を、あらかじめ決めておくことです。 手順が頭の中にしかないと、事故の最中に判断が止まり、止めるべきものを止められません。
フェーズ1・2:見極めて、止める
トリアージ
最初に、起きていることが通常の活動なのか、設定ミスなのか、セキュリティの問題なのかを見極めます。
いつ始まったのか、どのアプリが関わっているのか、どのデータに影響があるのかを確認します。
機密データにリスクがある場合は、完全な情報が揃うのを待たずに次の行動に移ります。
封じ込め
被害が広がらないように止めます。
エージェントが使うツールの無効化、アクセス権の取り消し、アカウントの停止などです。
このとき、誰が承認し、何を止めたのかを必ず記録します。
後の調査や復旧で、「どこまで止まっているのか」が分からなくなるのを防ぐためです。
止める手段と、止める判断をしてよい人は、平時に決めておきます。 夜間や休日に起きたとき、承認者が見つからずに数時間が過ぎる、というのはよくある失敗です。
連絡先の一覧も用意しておきます。 業務システムの管理者、エージェントの開発担当、セキュリティの担当、法務や広報、そして外部のAIモデル提供者や開発の委託先。 AIのやり取りは複数のシステムをまたぐため、関係者も社内外に広がります。
フェーズ3〜5:調べて、直して、学ぶ
調査
ログには保存期間があります。消えてしまう前に、まず証拠を保存します。
そのうえで、何が・いつ・どの順番で起きたのかを簡単なタイムラインにまとめます。
機密を含む調査結果は、必要な人だけに共有します。
ここで効いてくるのが、本番前に決めておいたログの関連付けです。 チャットでの依頼、アプリへのリクエスト、エージェントが選んだツール、業務システムでの更新を1本の時系列に並べられれば、原因の特定は格段に速くなります。
修復と復旧
原因となった過剰な権限やポリシーを直し、影響を受けたレコードは承認済みの手順で修正します。
修正後は再テストを行い、最小の検証済みの機能から段階的に再開します。
再開した直後は、ふだん以上に注意深く監視します。
教訓
振り返りの目的は、責任追及ではなく記録です。
何があれば防げたのか、何があればもっと早く気づけたのかを特定し、是正措置ごとに担当者と期限を決めます。
インシデントは、改善が検証されて初めて「終了」とします。
同じ種類の事故がもう一度起きたとき、前回より早く気づき、小さく止められるか。それが改善の物差しになります。
具体例:エージェントが大量のレコードを書き換えたら
たとえば、営業データの整備を任せたエージェントが、指示を取り違えて顧客レコードを一括で更新してしまったとします。 手順が決まっていない会社では、誰が止めるのか、どのログを見ればよいのかで時間を失い、その間にも更新は続きます。
手順があれば、やることは明確です。 まずツールを無効化して止め、止めた人と範囲を記録する。 ログが消える前に保存し、どの依頼がこの更新につながったのかを関連付けたログからたどる。 承認済みの手順でレコードを戻し、権限を見直したうえで、小さな範囲から再開します。
手順書は、作って終わりにしないことも大切です。 本番前に一度、こうした想定の事故を机上で通しておくと、「この操作は誰の権限でできるのか」「このログは何日で消えるのか」といった穴が見つかります。
事故を小さくするための追加の備え
監視と対応手順に加えて、事故が起きても被害を小さくとどめる仕組みも用意しておくと安心です。
- エージェント経由のアクセスを識別する:人の操作とエージェントの操作を区別し、それぞれにポリシーを適用する
- AIの入出力を守る:プロンプトや回答に含まれる個人情報を検出し、隠すガードレールを置く
- 持ち出しを防ぐ:外部への書き出しに行数の上限を設けるなど、大量のデータが一度に出ないようにする
- 戻せるようにする:スナップショットを取り、削除などの重要な操作には複数人の承認を求める(ランサムウェア対策にもなる)
特に、データの書き込みを行うエージェントには、エージェントのコードの外でポリシーを判定する仕組みと、監査の記録が欠かせません。 エージェント自身に「やってよいか」を判断させるのではなく、外側の仕組みで止められるようにしておくということです。
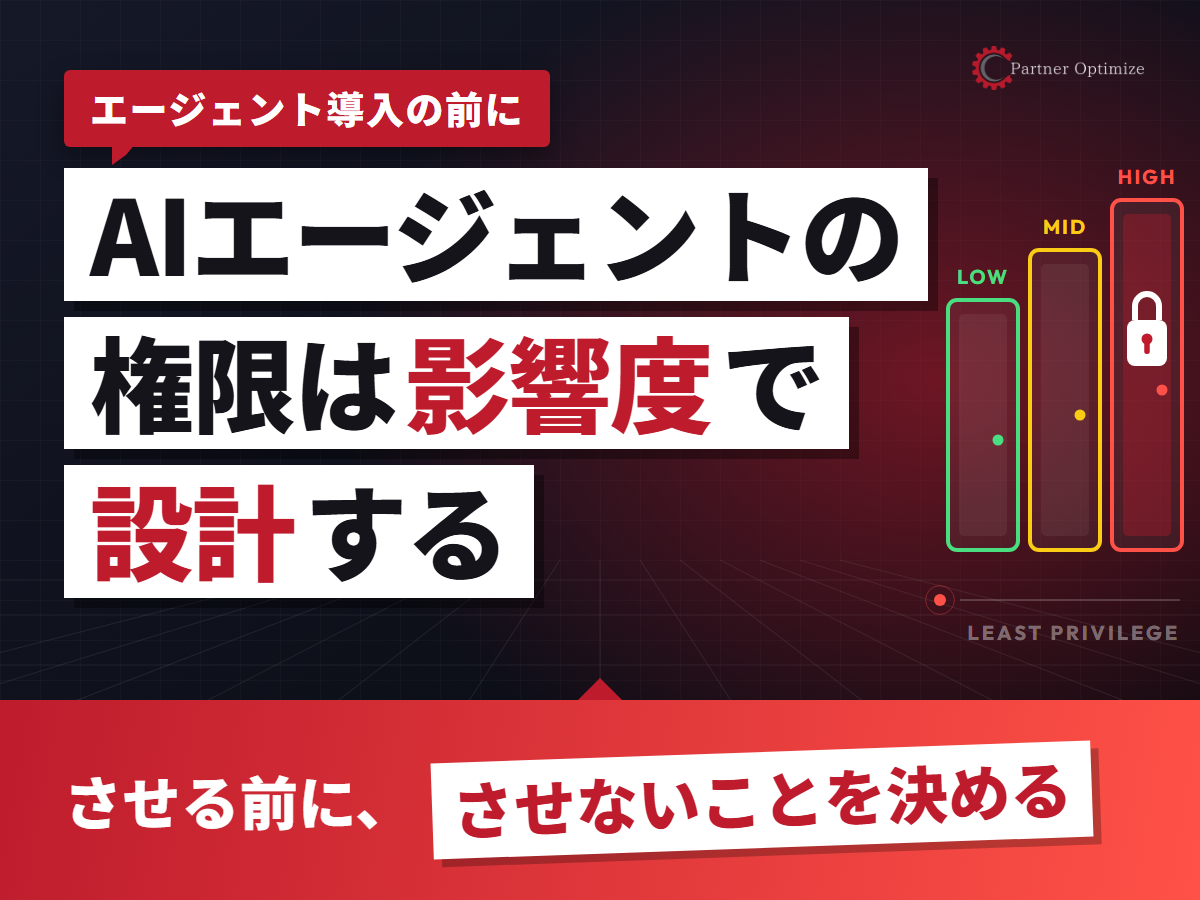
操作の影響度に応じて、自動化の段階を分けることも有効です。 影響度が低い操作は自動で実行し、中程度の操作は人が確認してから実行し、影響度が高い操作は正式な承認フローに回します。 すべてを自動にせず、すべてに承認を挟むこともしない。このバランスが、事故の大きさを左右します。
まとめ:本番稼働の前に確認したいチェックリスト
- やり取りがまたぐシステムと、それぞれのログの所在・アクセス権・保存期間を文書にしたか
- 各システムのログを、共通のIDや時刻で関連付けられるか
- 通常の活動のベースラインを把握し、異常に気づける仕組みがあるか
- ツールの無効化やアカウント停止を、誰の判断で、どの手段で行うか決まっているか
- 影響を受けたレコードを戻す、承認済みの手順とスナップショットがあるか
- 振り返りの是正措置に、担当者と期限を付ける運用になっているか
AIエージェントの事故対応は、特別なものではありません。 これまでのシステム運用で培ってきた監視とインシデント対応を、AIのやり取りの流れに合わせて設計し直すことです。 私たちは、エージェントの開発とあわせて、ログの関連付けや対応手順の整備まで含めて、本番稼働を支援しています。
AIエージェントの本番導入や、監視・インシデント対応の設計もご相談ください。
AI受託開発を見る