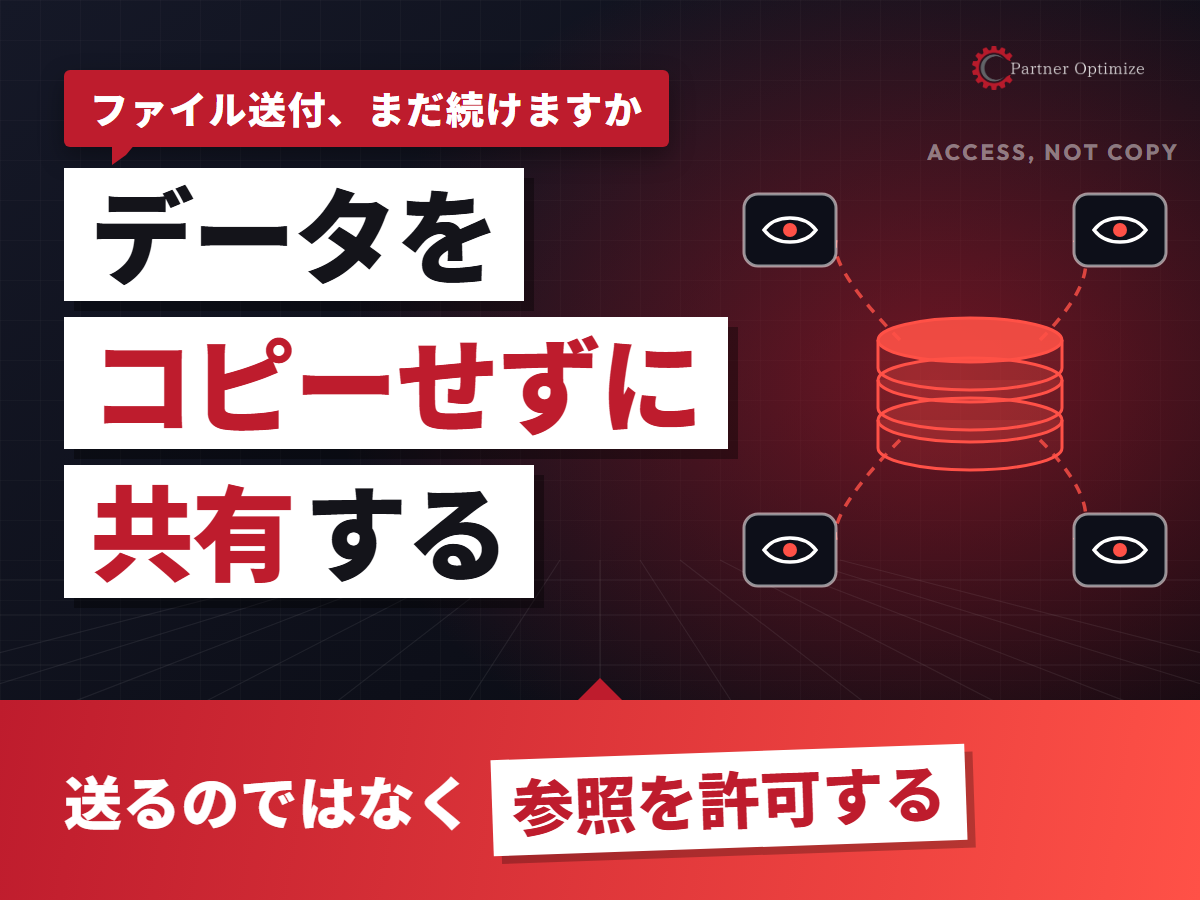
取引先やグループ会社とデータをやり取りするとき、今もファイルを書き出して送る方法が主流です。 しかし最近は、データを相手に渡さずに「見てよい範囲を許可する」共有のしかたが広がっています。 コピーしない共有で何が変わるのか、先行する企業の取り組みとあわせて整理します。
「コピーして渡す」が生む3つの問題
データを抽出し、ファイルにしてメールやファイル置き場で送る。相手はそれを自社のシステムに取り込む。 長く続いてきたこのやり方は、手軽な反面、相手が増えるほど次の3つの問題が大きくなります。
- コストが増える:同じデータが送り手と受け手の両方に保管され、抽出・変換・送付・取り込みの処理が、相手の数だけ、毎回発生する
- ガバナンスが分断される:一度渡したデータが、相手の環境でどう使われ、誰に回されたかを追えない。取引が終わっても、消えたかどうか確かめられない
- 文脈が断たれる:ファイルになった瞬間、項目の意味や更新日時、元のデータとのつながりが失われる。受け手は「いつ時点の、どういう定義の数字か」を問い合わせることになる
いずれも、データを「複製して渡す」ことそのものから生まれる問題です。 そこで注目されているのが、複製をやめて「アクセスを許可する」という考え方です。
「アクセスを許可する」共有とは
アクセス型の共有では、データは提供する側の基盤に置いたままにします。 相手に渡すのはデータそのものではなく、「この範囲なら見てよい」という参照の権限です。
提供元でデータを更新すれば、相手は常に最新の状態を見られます。 権限を外せば、その瞬間から見られなくなります。 誰が、いつ、何を見たかの記録も、提供元の側に残ります。
準備にかかる時間も大きく変わります。 海外のあるアパレル企業では、取引先との共有の設定にかかる期間が、6〜8週間から半日未満に縮まりました。 ファイルの形式や送り方を相手ごとに取り決める必要がなくなるためです。
また、オープンなデータ形式で共有することで、相手が同じ製品を持っていなくても受け取れる方式も広がっています。 「相手も同じ仕組みを入れていないと使えない」という制約は、以前より小さくなっています。
ただし、アクセス型にすれば何も考えなくてよい、というわけではありません。 データが提供元に残る以上、「どの範囲を、誰に、いつまで見せるか」を決める責任は、提供元が持ち続けます。 また、相手がデータを参照するときの計算の費用を、どちらが負担するのかも、最初に取り決めておく必要があります。 ファイル送付では送った時点で手を離れていたものが、アクセス型では「見せ続ける運用」に変わる、と考えると分かりやすいでしょう。
事例:300社超の取引先と、行単位で共有する
ある大手商社系の流通グループは、300社を超える取引先とデータを共有しています。 取引先ごとに専用の受け取り口(アカウント)を用意し、同じデータの中から、その取引先に関係する行だけが見えるように制御しています。 共有したデータを見るためのアプリには、多要素認証をかけています。
課題になったのは、設定の量です。取引先1社あたり3種類の設定を300社分行うと、初期構築だけで900回の作業になります。 そこで、命名規則と設定内容を表にまとめ、表から自動で作成する仕組みにしました。
相手が数社のうちは手作業でも回りますが、数百社になると、設定そのものが運用の負担とミスの原因になります。 アクセス型の共有を広げるなら、「設定を表で管理し、自動で反映する」ことを最初から前提にしておくのが現実的です。
事例:グループ会社間の連携を組み替える
ある大手金融グループでは、従来、グループ会社の間を専用線でつないでデータをやり取りしていました。 専用線は安全な一方で、接続先を1つ増やすたびに手間がかかり、連携の範囲を広げにくいという課題がありました。
共有のファイル置き場を使う案も検討されましたが、見送られました。 会社とデータの組み合わせごとに権限を設定する必要があり、その数が会社の数に対して「二次関数的に」増えていくためです。
二次関数的に増えるとは、会社の数が2倍になると、管理すべき組み合わせがおよそ4倍になるということです。 グループ会社どうしが互いにデータをやり取りする形では、つながりの数は会社の数よりずっと速く増えていきます。 最初は管理できていても、数年後に誰も全体を把握できなくなる典型的なパターンです。
最終的には、持株会社がまとめて基盤を契約し、各社に受け取り口を用意する形にしました。 顧客が同意した先にだけデータを出す制御を組み込み、「必要な人に、必要な分だけ」を仕組みで担保しています。 利用状況を確認するための監視アプリも各社に配布しており、将来は外部のデータも集めていく方針です。
同じような動きは、ほかの業種にも広がっています。 ある通信会社は、グループ会社とのデータ共有で、各社のデータを物理的に1か所へ移さず、仮想的に集約しています。 ある信託銀行グループでは、グループ会社が作ったAIエージェントも、データ共有と同じ手順で共有できました。 データのために作った権限の設計が、AIの共有にもそのまま使えたということです。
これは、これからAIエージェントを業務に広げていく企業にとって重要な示唆です。 AIエージェントは、人の代わりにデータを読み、判断し、動きます。 そのとき「このエージェントは、どの会社の、どのデータまで見てよいか」を決めるのは、データ共有の権限と同じ考え方です。 データ共有の仕組みを先に整えておくことが、AIを安全に共有するための土台にもなります。
個人に関わるデータは「見せ方」で守る
会員や患者など、個人に関わるデータを共有するときは、さらに一段の工夫が要ります。 会員1.3億人以上を抱えるあるポイントサービス会社は、グループ横断の広告ネットワークのためにデータを共有しています。 その際、データを渡すのではなく、次のような仕組みで「見せ方」を制御しています。
- 少人数の集計は返さない:会員がN人未満になる集計は、結果を返さない。少人数の集計から個人が推測されるのを防ぐ
- 識別子は「突き合わせ」にだけ使える:会員を識別する値は、データ同士の突き合わせには使えるが、値そのものは出力できない
- マスキングと行単位の制御:見せる必要のない項目は伏せ、参加する会社ごとに見てよい行だけに絞る
複数の会社がデータを持ち寄って分析する「データクリーンルーム」では、参加する会社ごとに専用のキーでデータを暗号化し、 ハッシュ化したキーで突き合わせています。お互いの生のデータを見せ合わずに、重なりだけを分析できる仕組みです。
医療の分野でも同じ流れがあります。2,076万人分のデータを扱うある医療データ企業は、 今後、データの渡し方を「コピー」から「アクセス」に変えていく計画です。 機微なデータほど、複製を減らすことが、そのまま守りの強化につながります。
具体例:ファイル送付の「その後」
ファイル送付の問題は、送った瞬間ではなく、その後に表れます。よくある場面で見てみます。
ファイルを送るやり方では、取引を終えるときに「相手の手元のデータをどうするか」という問題が必ず残ります。 参照の許可であれば、データは最初から相手の手元にありません。止めたいときに、提供元の側で止められます。
社内の共有も「マーケットプレイス」に
同じ考え方は、社外だけでなく社内にも当てはまります。 部門ごとにデータを抱え込み、必要になるたびに「あのデータをください」と依頼してファイルを受け取る。 これも、社内で起きている「コピーして渡す」です。
そこで、社内向けの「データのマーケットプレイス」をつくる企業が増えています。 データを持つ部門が、説明を付けてデータを公開し、使いたい部門が申請して、承認されれば参照できるようになる仕組みです。 どの部門がどのデータを使っているかが見えるようになり、同じデータの複製が社内に散らばることも防げます。
ポイントは、データを公開する側に「説明」を求めることです。 項目の意味、更新の頻度、問い合わせ先が添えられていれば、使う側は安心して使えます。 ファイルの受け渡しで失われていた「文脈」を、データと一緒に届ける仕組みだと言えます。 社内で共有の作法が根づいていれば、社外との共有に広げるときも、同じ手順をそのまま使えます。
始める前に決めておきたい5つのこと
アクセス型の共有は、仕組みを入れれば終わりではありません。最初に次の5つを決めておくと、相手が増えても破綻しにくくなります。
- 誰に:受け取り口を、取引先ごと・会社ごと・部門ごとのどの単位で用意するか
- どこまで:見せる行・項目・集計の細かさをどう絞るか。少人数の集計を返さないなどの条件も含める
- どの条件で:契約や顧客の同意と、共有の範囲をどう結びつけるか
- どう確かめるか:誰が何を見たかの記録と、利用状況の監視を誰が見るか
- どう増やすか:命名規則と設定を表で管理し、相手が増えても自動で反映できるか
まとめ:データ共有を見直すためのチェックリスト
- 取引先やグループ会社に、定期的にファイルを送っている業務はいくつあるか
- 取引が終わった相手の手元のデータを、消えたと確かめられるか
- 送ったデータが「いつ時点の、どの定義の数字か」を、相手が分かる形になっているか
- 共有先が増えたとき、権限の設定を手作業で増やし続ける前提になっていないか
- 個人に関わるデータについて、少人数の集計や識別子の出力を防ぐ仕組みがあるか
- 社内でも、データの依頼とファイルの受け渡しが繰り返されていないか
データ連携というと、「どうやって送るか」を考えがちです。 これからは、「送らずに、どこまで見せるか」を設計することが連携の中心になっていきます。 私たちは、データを複製する前に、まず参照の許可で済ませられないかを検討することをおすすめしています。 権限と記録の設計を先に固めておけば、取引先やグループ会社、そしてAIへの共有にも、同じ仕組みを広げていけます。
取引先・グループ会社とのデータ共有の設計も、ご相談ください。
データ連携開発を見る