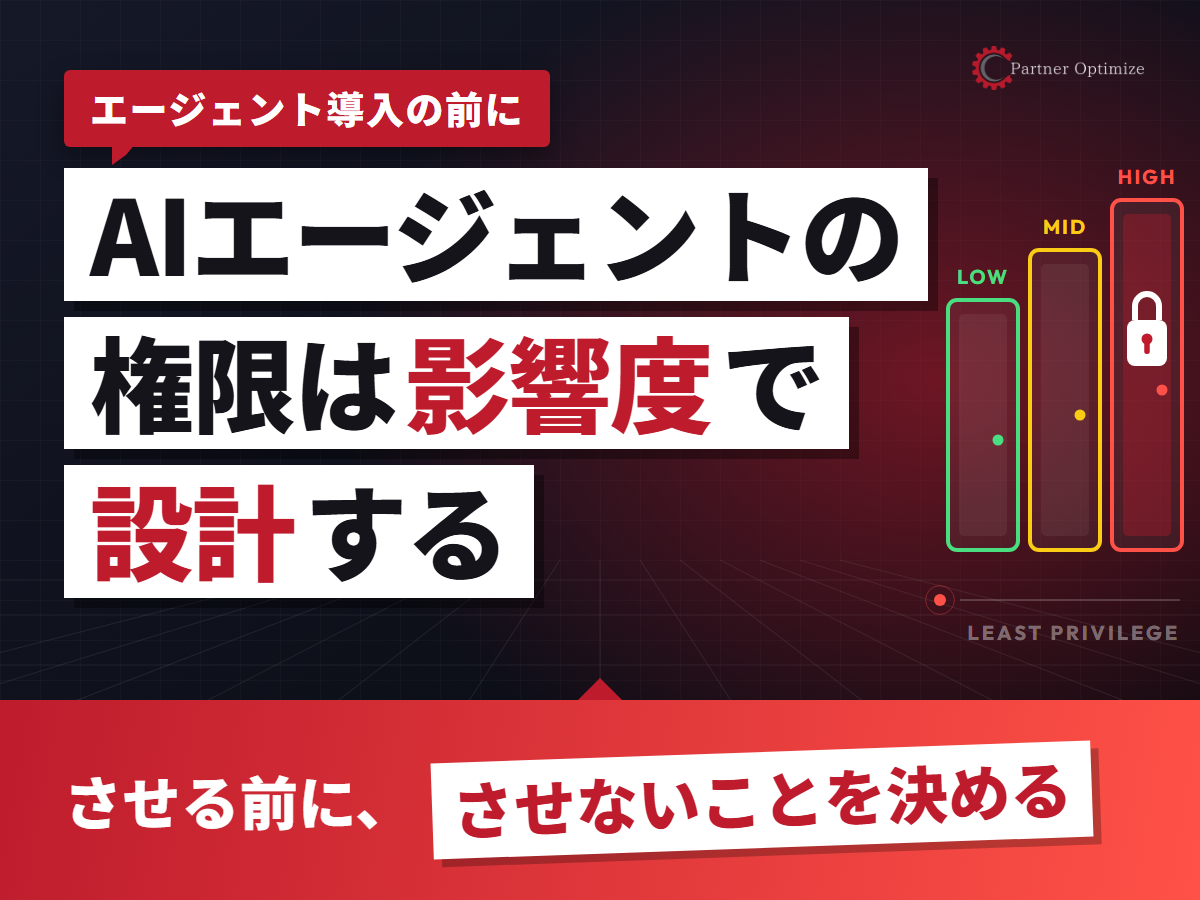
AIエージェントに業務を任せるとき、最初に決めるべきは「何をさせるか」より「何をさせないか」です。 とはいえ、すべてを禁止すればエージェントを入れた意味がなくなります。 権限を、データと操作の「影響度」から組み立てる実務の手順を、4つのステップで整理します。
出発点は「この業務に必要な最小限は何か」
AIのセキュリティの全体像は、以前の記事「AIエージェントに顧客データを渡す前に」で、1本の木にたとえて紹介しました。 その中で、いちばん効くのは「根」にあたる権限設計だとお伝えしています。 今回は、その権限設計を現場でどう進めるかに絞って掘り下げます。
土台になるのは最小権限の原則です。 各ユーザー・アプリ・エージェントに、そのタスクに必要なアクセス権だけを与える。 設計の出発点は、いつも「この利用者が実務で必要な最小限の権限は何か」という問いです。
庭木は、伸びすぎた枝を剪定することで、かえって幹が太く丈夫になります。 権限も同じで、使われていない権限や広すぎる権限を見直すほど、仕組み全体が強くなります。 「念のため広めに付けておく」は、AIエージェントの時代には通用しません。 人なら使わずに済んでいた権限も、エージェントは指示しだいで使ってしまうからです。
私たちは、この問いに答えるための手順を、次の4ステップで進めています。
手順1:ID ― エージェントは「誰として」動くのか
SF映画には、人の指示にAIが「申し訳ありません、それはできないのです」と答える有名な場面があります。 業務のエージェントに求めたいのは、まさにこの振る舞いです。 ただし、気分で断るのではなく、依頼した人のIDに基づいて、実行してよいかどうかを判断させます。
そのためにまず決めるのが、エージェントを「誰の権限で」動かすかです。設計は大きく2通りあります。
- 利用者本人の権限で動く:エージェントは、話しかけている人と同じ権限でデータを見ます。同じ質問をしても、レコードへのアクセス権が違えば、返ってくる答えも違います。既存の権限設計をそのまま活かせるのが利点です
- 専用の連携用ユーザーの権限で動く:エージェント専用のユーザーを用意し、その権限で動かします。利用者が誰であっても同じ範囲にアクセスするため、範囲を明確に絞り込んでおく必要があります
社員が使う社内向けのエージェントなら、基本は利用者本人の権限で動かすのが安全です。 一方、お客様向けの窓口のように、利用者がシステムのアカウントを持たない場面では、連携用ユーザーを使うことになります。 その場合は「このユーザーには何が見えて、何ができるのか」を一覧にして、業務の責任者と一緒に確認します。 連携用ユーザーに管理者並みの権限を付けてしまうのが、最もよくある失敗です。
どちらの方式でも、エージェントが行った操作の記録には「誰からの依頼で、どのIDとして実行したか」を残しておきます。 連携用ユーザーの名前しか残っていないと、問題が起きたときに、実際に依頼した人までたどれなくなるからです。
手順2:データと操作を、影響度で3段階に分ける
次に、エージェントが触れるデータを、機密性と影響の大きさで分類します。 私たちは、信号と同じ3色で整理することをおすすめしています。
- 低(緑):公開済みの情報や、間違って見えても影響が小さいデータ(例:商品の説明、ケースの対応状況)
- 中(黄):社内向けの業務データ(例:取引の履歴、問い合わせの内容)
- 高(赤):漏れたり書き換えられたりすると重大な影響が出るデータ(例:支払い情報、個人情報、与信の条件)
分類ができたら、それぞれのデータに対して「表示・作成・削除」のどれを許すかを決めます。 データの色と操作の重さを掛け合わせると、エージェントに任せてよい範囲が見えてきます。
この分類は、情報システム部門だけで決めないことが大切です。 「この項目が書き換えられたら、業務にどんな影響が出るか」を一番よく知っているのは、業務の責任者だからです。 私たちは、業務の担当者と一緒に項目を1つずつ確認しながら色分けしていきます。
ある銀行は、サービスエージェントに「ケースの状況と優先度だけを返す参照専用の操作」を公開し、 支払い関連の項目は、エージェントが使える機能から最初から外しました。 こうしておけば、エージェントが悪意ある指示を受け取ったとしても、機密データには届きません。 「AIに断らせる」のではなく、「そもそも届かない」ように作るのがポイントです。
参照専用から始める5つの原則
分類の結果を実際の権限に落とし込むときは、次の5つを守ります。
- データを変更しないなら、参照専用から始める:問い合わせへの回答や状況の確認だけなら、更新の権限は要りません
- 返すのは、タスクに必要なものだけにする:オブジェクト・項目・レコードのそれぞれで、必要な範囲に絞ります
- 広く漠然としたリクエストにしない:「顧客データを全部取得」ではなく、条件を指定した具体的なクエリにします
- 広い編集権限ではなく、限定的なアクションにする:「レコードを自由に編集できる」ではなく、「対応メモを追記する」のようにタスク単位で用意します
- 更新の権限は、あとから足す:参照専用の設計をテストし、承認されてから更新の権限を追加します
最初から「できること」を広げるより、狭く始めて必要に応じて足すほうが、結果的に早く本番に進めます。 セキュリティの審査で止まる時間が、ぐっと短くなるからです。
手順3:更新させるなら、ガードレールを先に決める
エージェントにデータを更新させる段階になったら、操作ごとに次の5点を明確にしておきます。
- 誰からの依頼なら実行してよいか(承認された依頼者)
- どのレコードの、どの項目を変更するのか
- 入力として有効な値は何か
- 実行してよいビジネス上の条件は何か
- 確認や承認のステップを、どこに挟むか
このうち「確認や承認をどこに挟むか」は、影響度で段階的に変えます。 すべてに承認を挟めば業務が止まり、すべてを自動にすれば事故が起きます。
- 影響度・低:範囲が限定的で取り消せる操作は、検証済みの入力で実行を許可する(例:残高の照会)
- 影響度・中:AIが変更案を出し、人が確認してから実行する(例:身に覚えのない請求への異議申し立て。AIが取引を確認して解決策を提案し、担当者が承認する)
- 影響度・高:人の承認フローや、既存の業務プロセスに回す(例:利用限度額の大幅な引き上げは、上長の承認を必須にする)
元に戻せない操作や、機密性の高い領域ほど、より厳しい段階に置きます。 逆に言えば、取り消せる操作であれば、エージェントに任せる範囲を思い切って広げられます。
手順4:「断られること」を繰り返しテストする
エージェントのテストというと、「正しく答えるか」「正しく動くか」に目が向きがちです。 権限設計で同じくらい大切なのは、権限のないリクエストが、正しく拒否されるかを確かめることです。
- テスト環境で、管理者ではなく実際のエンドユーザーのIDと権限で実行する
- 見えてはいけないレコードや項目を、言い回しを変えて何度も聞き出そうとしてみる(例:担当外の顧客の支払い情報を聞く、別の人の名前をかたって依頼する)
- 影響度・中や高の操作が、確認や承認のステップを飛ばして実行されないかを試す
- 結果を記録し、権限や指示を変えたときに同じテストをやり直せるようにする
管理者のアカウントで試すと、権限の問題はほとんど見つかりません。 また、エージェントは指示文やモデルの更新で振る舞いが変わります。 一度確かめて終わりではなく、変更のたびに再テストできる形で残しておくことが重要です。
実装で押さえたい3つの仕組み
4つの手順を支えるために、システムの側でも次のような仕組みを用意しておくと運用が楽になります。
1. エージェント経由のアクセスを見分ける
同じ利用者でも、画面から直接操作するときと、エージェント経由でアクセスするときでは、許す範囲を変えたい場面があります。
アクセスの経路を識別して、エージェント経由のときだけ適用するポリシーを持てるようにしておきます。
2. 書き込むエージェントには、コードの外で判定と記録を
更新を行うエージェントでは、「実行してよいか」の判定をエージェントの指示文やプログラムの中に埋め込まず、
外部のポリシーとして判定し、その結果を監査記録として残します。
ルールの変更や、事故のあとの調査がしやすくなります。
3. 権限を「AIに使わせてよい区画」と「機能単位のロール」で組む
あるOA機器メーカーでは、データの置き場所を「AIに使わせてよいデータの区画」とそれ以外に分け、権限設計の単位にしています。
あるエンタメ企業では、ロールを機能単位に細かく分け、AIからのアクセスは参照専用で運用しています。
どちらも、「このデータはAIに見せてよいか」を個別に議論しなくて済む構造にしているのが共通点です。
まとめ:権限設計を始める前の確認リスト
- エージェントは、利用者本人の権限と連携用ユーザーの権限の、どちらで動くか決めているか
- 連携用ユーザーを使う場合、その権限の範囲を一覧にして確認しているか
- 扱うデータを、影響度の低・中・高に分類しているか
- データごとに、表示・作成・削除のどれを許すか決めているか
- データを変更しない用途は、参照専用から始めているか
- 更新の操作ごとに、依頼者・対象・入力値・条件・承認の5点を定義しているか
- 権限のないリクエストが拒否されることを、実際の利用者の権限でテストしているか
AIエージェントの権限設計は、特別な技術というより、業務の棚卸しに近い作業です。 誰が、どのデータに、どこまで触れてよいのか。それを影響度で整理し、狭く始めて、テストしながら広げていく。 私たちは、この手順を業務の担当者と一緒に進めることで、安全に使われ続けるエージェントづくりをお手伝いしています。
AIエージェントの導入や、既存環境の権限設計の見直しもご相談ください。
AI受託開発を見る