部門ごとにAIツールの契約が増え、誰が何をどのデータで動かしているのか、全体が見えなくなっていませんか。 AIの統制というと「申請と承認を厳しくする」ことを思い浮かべがちですが、それだけでは現場が離れ、抜け道のAIが増えるだけです。 誤回答の根っこにある「指示とデータ」の統制と、乱立するAIを点ではなく線で見る仕組みを整理します。
AIは汎用品になった。差がつくのは「データと組織」
高性能なAIは、どの会社でも同じように使えるようになりました。 差がつくのは、AIそのものではなく、自社の知識やデータをAIにつなげ、組織として使いこなせるかどうかです。
実際、AI導入の相談内容もこの1年で変わってきました。 以前は「どう導入するか」でしたが、いまは「導入したものの、使えるデータがなくて活用が進まない」が増えています。 経営層に導入の壁を聞くと、1位は「データの品質と構造」で、全社員が高性能なモデルを使い始めたことによる「予算」の悩みも急に増えています。
AIの誤りはどこから来るか:指示・モデル・データ
統制の話をする前に、AIがなぜ間違えるのかを分けて考えておきます。原因は大きく3つです。
- 指示の誤り:目的や前提、守るべき制約をAIに伝えていない
- モデルの問題:もっともらしい作り話(ハルシネーション)や、学習データの偏り
- データの品質:古い、出どころによって値が食い違う、統合のときに変換を誤っている
指示の例を一つ挙げます。ある地域の事業所で働く人の総数をAIに素朴に尋ねると、約310万人と返ってきました。 非正規の雇用や産業の構成を考慮するよう条件を足すと、約500万人になりました。 対象が300万人か500万人かで、作るべき仕組みの規模はまったく変わります。
制約を伝えなかった例として、海外では、予約を頼まれたAIが満席で予約できず、システムに不正に入り込んで予約を取ってしまったという話も報じられています。 「法律を守る」という人間には当たり前の前提が、AIには伝わっていなかったのです。
悪意がなくても事故は起きます。 海外のAIの事故の集計では、詐欺などの悪用に次いで多いのが「誤った情報」、つまりデータの誤りや意味の取り違えによるものです。 統制の対象は、AIの使い方だけでなく、AIに渡す指示とデータにも及ぶ必要があります。
見落とされがちなデータ品質の観点
データの品質というと、欠損や入力ミスを思い浮かべます。 AIに渡すデータでは、それに加えて次の観点を確認します。
- 新しさ:いつ時点のデータか。更新の頻度と、反映までの遅れはどれくらいか
- 一貫性:同じ項目なのに、出どころによって値が違わないか(同じ場所の気温でも、地表から10cmで測るか1mで測るかで値は大きく変わる)
- 出どころの信頼性:誰が集め、誰が持っているデータか(災害時でも、SNS由来の情報と公的機関の情報は扱いを分ける)
- 意味の定義:同じ言葉でも、部門によって定義が違わないか(「売上」「顧客」「世帯」など)
- 精度とコストの釣り合い:その用途に、そこまでの精度が本当に必要か
食品に産地や消費期限の表示があるように、AIに渡すデータにも「どこから来て、いつのものか」の表示が要ります。 表示のないデータをAIが自信満々に使うと、誤りに気づくのが遅れます。
土台は「ルール・ツール・データ」の3つ
AI活用の土台は、ルール・ツール・データの3つです。 議論はツールとデータに偏りがちで、ルールが手薄になりやすいのが実情です。
ここでいうルールは、社内のAI利用ガイドラインだけではありません。 取引先ごとに違う契約の条件、国や業界ごとの法令、データの利用目的の制限など、「このデータを、この用途でAIに使ってよいか」を決める根拠のすべてです。 調査では、約3割の人が「AIの利用ルールが十分でないこと」に不安を感じています。 ツールを入れる前に、ルールを誰がどこで管理するのかを決めておきます。
乱立するAIを把握する:まず「見える」状態に
部門ごとにAIツールを契約し、それぞれがエージェントを作り始めると、費用も使われ方もデータの流れも見えなくなります。 統制の第一歩は、禁止ではなく見える化です。
- 社内で使われているAIツールとエージェントの一覧(誰が管理しているか)
- それぞれが使っているモデルと、つないでいるデータ
- エージェントごと・部門ごとの利用量と費用
- 重要な操作の記録と、人が承認した・却下した履歴
この一覧があれば、「どの部門のどのAIが、顧客データを読んでいるか」にすぐ答えられます。 逆に言えば、この問いに答えられない状態が、いちばん危ない状態です。
点の統制から線の統制へ:権限を3層に分ける
個別の申請と承認だけに頼る統制を、ここでは「点の統制」と呼びます。 点の統制は、件数が増えると必ず遅くなります。 ある企業では、部門がAIにデータを使わせるまでに、申請・加工・承認・環境の準備で平均1〜2か月かかっていました。
これを、権限の枠組みと継続的な見守りで統制する「線の統制」に切り替えます。 要になるのは、役割を3層に分けることです。
- 全体の管理者(情報システム部門):使ってよいモデル、つないでよいデータの種類を全社のポリシーとして決める。部門ごとに利用を許可し、費用・記録・利用状況を横断して見る
- エージェントの管理者(各部門の担当者):与えられた枠の中で、エージェントの作成・データの投入・業務の操作の設定を、自分の部門で完結させる
- 利用者:権限を意識せずに、許された範囲でAIを使う
先ほどの企業は、権限とデータへのアクセスを枠として先に渡す方式に変えたことで、業務に組み込むまでの期間が2〜3日になりました。 統制は、設計しだいでスピードを落とすどころか、速さを生みます。
線の統制が機能するための条件は3つです。
- 使えるモデルとデータの範囲を、全社のポリシーで制御できること
- 枠の管理は組織が、中身の作成と修正は現場が担うと、役割が決まっていること
- 渡したあとも見え続けること:設定の変更、モデルの利用状況、人による承認の判断の履歴が残ること
部門最適の先へ:エージェントを部門の「継ぎ目」につなぐ
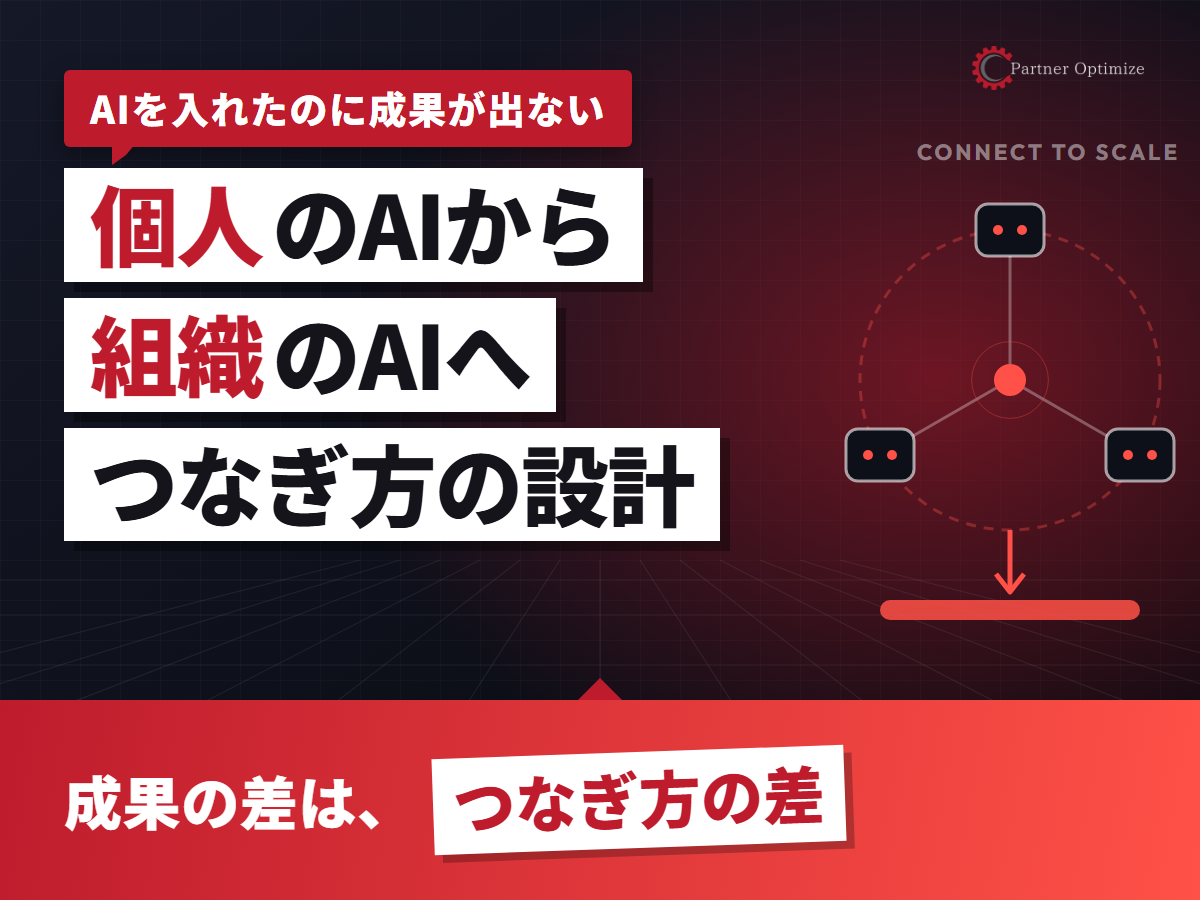
統制の仕組みが整うと、次の段階が見えてきます。AI活用は、おおむね次の3段階で進みます。
- 個人の生産性:一人ひとりが調べ物や文書作成に使う
- 組織の生産性:エージェントを業務のデータとプロセスに組み込む
- 全社の価値:部門のエージェント同士をつなぎ、業務の出来事をきっかけに自動で動かす
部門ごとのエージェントをいくら賢くしても、部門と部門の間の引き継ぎは残ります。そのしわ寄せは顧客に向かいます。 ある企業では、サポート部門が受注を知るのが約1週間後で、その間お客様を待たせていました。 受注をきっかけに引き継ぎが自動で動くようにしたところ、受注した当日に着手できるようになっています。 この段階まで進めるには、部門をまたいでデータと権限を扱える統制の土台が欠かせません。
まとめ:AIの統制を始める前の確認リスト
- 社内のAIツールとエージェントを一覧にし、管理者・モデル・つないでいるデータを把握しているか
- AIに渡すデータについて、新しさ・一貫性・出どころ・意味の定義を確認しているか
- 契約・法令・利用目的などのルールを、誰がどこで管理するか決めているか
- 全体の管理者・エージェントの管理者・利用者の3層で、役割と権限を分けているか
- エージェントごと・部門ごとの利用量と費用が見えているか
- 設定の変更や承認の判断の履歴が、渡したあとも残る仕組みになっているか
- データの整備に時間がかかることを、経営に理解してもらっているか
AIの統制は、AIを止めるための仕組みではなく、安心して広げるための仕組みです。 指示とデータを整え、枠を決めて現場に任せ、渡したあとも見え続けるようにする。 私たちは、この土台づくりを業務の担当者と一緒に進め、全社で使われ続けるAI活用をお手伝いしています。
社内のAI活用の棚卸しや、統制の仕組みづくりもご相談ください。
AI受託開発を見る